À mesure que l’IA en périphérie s’étend de la vision au déploiement local de modèles linguistiques à grande échelle (LLM) et de modèles de langage à grande échelle (VLM), les accélérateurs IA M.2 constituent désormais un moyen pratique d’améliorer les performances d’inférence d’un ordinateur dédié à l’IA en périphérie sans avoir à remplacer l’ensemble de la plateforme. Cependant, le choix de l’accélérateur adapté ne se résume pas à une simple comparaison des TOPS, de la mémoire, du débit de données PCIe et de la conception thermique. D’autres facteurs, tels que la compatibilité logicielle et la charge de travail réelle, peuvent également influencer les performances en conditions réelles. Alors, quels sont les critères à prendre en compte lorsque vous choisissez un accélérateur IA M.2 pour l’IA en périphérie ?
1. Commencez par la charge de travail, et non par le chiffre TOPS

Avant de comparer les cartes accélératrices, déterminez ce que le système doit réellement faire.
Un projet de détection d'objets à l'aide d'une seule caméra et un déploiement local d'un modèle de langage de grande envergure (LLM) peuvent tous deux relever de la catégorie générale de l'IA en périphérie, mais leurs exigences matérielles sont totalement différentes.
Dans le cadre d'une application de vision industrielle, les vraies questions sont généralement d'ordre pratique. Combien y a-t-il de flux vidéo ? Quelles sont la résolution et la fréquence d'images requises ? Où auront lieu le décodage et le prétraitement vidéo ? Quelle est la latence de bout en bout acceptable ?
Un LLM ou un VLM soulève une série de questions différentes. L'architecture du modèle, le nombre de paramètres, la quantification, la longueur du contexte, la concurrence et la vitesse de génération de tokens attendue sont autant de facteurs qui influent sur les exigences matérielles.
Le nombre de paramètres est utile, mais uniquement à titre indicatif.
Un modèle 7B n'est pas une spécification matérielle. Deux modèles présentant un nombre de paramètres similaire peuvent se comporter différemment en raison de leurs architectures, de leurs modes d'accès à la mémoire et de leurs environnements d'exécution différents. Les modèles denses et les modèles de type « mélange d'experts » en sont un exemple évident : le nombre total de paramètres ne suffit pas à lui seul à décrire la charge de calcul active pour chaque token.
Quantification cela change à nouveau la donne. La réduction de la précision du modèle peut réduire considérablement les besoins en mémoire et en puissance de calcul, mais le résultat exact dépend de la manière dont les poids, les activations et les données d'exécution sont gérés.
Donc, au lieu de commencer par “ Combien de TOPS devrions-nous acheter ? ”
Une meilleure séquence serait : Charge de travail → Modèle → Objectif de performance → Besoins en mémoire et en puissance de calcul → Matériel. Cela peut paraître simple, mais cela permet d'éviter un nombre surprenant de mauvais choix en matière de matériel.
2. Pour le déploiement local de modèles de langage de grande envergure (LLM), la mémoire peut être tout aussi importante que la puissance de calcul
Le TOPS a toujours été l'une des caractéristiques techniques phares des accélérateurs d'IA, en particulier dans le domaine de la vision par ordinateur.
Avec les LLM et les VLM, il devient beaucoup plus difficile de faire abstraction de la mémoire.
L'accélérateur doit stocker les poids des modèles, mais cela ne représente qu'une partie des besoins en mémoire. La surcharge d'exécution, les tenseurs intermédiaires et le cache KV consomment également de la mémoire. Des fenêtres de contexte plus longues et un nombre accru d'utilisateurs simultanés augmentent encore ces besoins.
C'est pourquoi deux accélérateurs IA M.2 dotés de caractéristiques de calcul impressionnantes peuvent tout de même convenir à des charges de travail très différentes.
Une carte dotée d'une mémoire locale relativement réduite peut convenir parfaitement à l'inférence visuelle ou à des modèles de petite taille. Une carte disposant d'une mémoire d'accélérateur bien plus importante peut prendre en charge une autre catégorie de charges de travail génératives ou multimodales, à condition que la pile logicielle soit compatible avec le modèle.
Si l'ensemble de travail complet ne tient pas dans la mémoire locale de l'accélérateur, cela ne signifie pas pour autant que le modèle ne peut pas s'exécuter. Certains systèmes peuvent recourir au déchargement vers la mémoire de l'hôte, répartir le modèle entre plusieurs périphériques ou utiliser d'autres techniques de gestion de la mémoire.
Il y a toutefois un compromis à faire.
Le transfert de données entre la mémoire de l'hôte et celle de l'accélérateur entraîne une surcharge. L'exécution sur plusieurs périphériques rend également l'architecture logicielle plus complexe. Dans les deux cas, le modèle peut techniquement fonctionner, mais avec une latence ou un débit bien moins satisfaisants.
Pour le déploiement local d’un modèle LLM, la compatibilité du modèle n’est qu’un point de départ. L’accélérateur doit encore répondre aux exigences de l’application en matière de vitesse de génération, de longueur de contexte et de concurrence. Dans la pratique, cela dépend de la puissance de calcul, de la mémoire de l’accélérateur, de la bande passante mémoire, de la quantification et de l’utilisation de la mémoire en exécution.
3. La bande passante PCIe est importante, mais il n'existe pas de règle universelle concernant le x4
Le Spécification M.2 C'est un autre domaine dans lequel on a tendance à simplifier à l'excès les spécifications.
La présence d'un emplacement M.2 ne permet pas de déterminer automatiquement quel bus est disponible, combien de voies PCIe sont connectées ni quelle génération de PCIe est prise en charge. De même, la compatibilité physique et le profil de la carte ne garantissent pas que l'interface électrique soit adaptée à l'accélérateur.
Donc oui, il est important de consulter la fiche technique du serveur.
Mais l'idée reçue selon laquelle un accélérateur d'IA haute performance doit toujours utiliser le PCIe x4 est trop simpliste.
Ce qui importe, c'est le flux de données entre le processeur hôte et l'accélérateur.
Supposons qu'un accélérateur dispose de sa propre mémoire locale. Le modèle est chargé sur l'accélérateur, la majeure partie du traitement par inférence s'y effectue, et l'hôte se contente principalement d'envoyer les données d'entrée et de recevoir les résultats. Dans cette architecture, le volume de trafic transitant par le bus PCIe peut s'avérer relativement limité.
Imaginons maintenant un ordinateur « edge » dédié à l'IA traitant plusieurs flux vidéo haute résolution provenant de caméras. La vidéo est décodée et prétraitée sur l'hôte, puis les images sont transférées en continu vers l'accélérateur. La bande passante PCIe revêt alors une importance bien plus grande.
Il en va de même lorsqu'une partie d'un modèle s'exécute sur le processeur et qu'une autre partie s'exécute sur l'accélérateur. Les transferts fréquents de tenseurs intermédiaires peuvent rapidement modifier les besoins en bande passante.
Les systèmes à accélérateurs multiples ajoutent un niveau supplémentaire de complexité, car le partitionnement des modèles et les transferts de données entre périphériques peuvent également avoir une incidence sur les performances.
Il convient donc d'évaluer le PCIe en fonction du débit réel des données du système plutôt qu'en se basant uniquement sur le nombre de TOPS. Ce qui importe, c’est de savoir d’où proviennent les données, où le prétraitement est effectué, où l’inférence est exécutée, et quel est le volume de trafic entre l’hôte et l’accélérateur pendant le fonctionnement. Ces facteurs permettent généralement de mieux déterminer si le PCIe constituera un goulot d’étranglement que le nombre de voies en lui-même.
4. Les performances durables dépendent de la conception électrique et thermique
Un accélérateur d'IA ne fonctionne pas tout seul.
À l'intérieur d'un ordinateur industriel de périphérie, il partage l'environnement thermique avec le processeur, la mémoire, le dispositif de stockage, les modules de communication et les autres composants électroniques.
C'est important car les installations industrielles offrent rarement les mêmes conditions de refroidissement qu'une paillasse de laboratoire ou un serveur de centre de données.
Les ordinateurs « Edge AI » peuvent être installés à l'intérieur d'armoires de commande, de boîtiers d'équipements, de machines de production, d'armoires situées en bord de route ou dans d'autres espaces où la circulation de l'air est limitée. Dans ces environnements, un test de performance de courte durée ne reflète pas nécessairement les performances à long terme.
Lorsque la température augmente, un processeur ou un accélérateur peut réduire sa fréquence de fonctionnement afin de rester dans les limites thermiques. La valeur TOPS théorique reste inchangée, mais le débit réel d'inférence peut diminuer.
Cet effet s'accentue à mesure que la puissance de l'accélérateur augmente ou lorsque plusieurs modules de calcul sont installés.
C'est pourquoi la conception électrique et thermique doit être évaluée au niveau du système.
Ne vous fiez pas uniquement à la puissance nominale de l’accélérateur. Tenez compte du processeur, du module d’IA, du dispositif de stockage, du modem cellulaire et des autres composants susceptibles d’être actifs simultanément. Les spécifications relatives à la température de fonctionnement du module et ses exigences en matière de refroidissement doivent également être vérifiées indépendamment des spécifications thermiques de l’ordinateur de base.
Une configuration à deux accélérateurs peut offrir une puissance de calcul IA théorique deux fois supérieure à celle d'une configuration à une seule carte, mais cela ne signifie pas pour autant que l'ensemble du système maintiendra automatiquement des performances d'inférence deux fois plus élevées à toutes les températures ambiantes.
Dans le cadre d'un véritable projet d'IA industrielle, des tests prolongés dans les conditions réelles de charge de travail et d'environnement sont plus utiles qu'un simple test de performance ponctuel visant à atteindre des pics de performance.
5. La pile logicielle détermine souvent la durée de l'intégration
C'est l'un des aspects les plus faciles à sous-estimer lors du choix d'un accélérateur d'IA.
Le matériel s'installe en quelques minutes. En revanche, il faudra peut-être beaucoup plus de temps pour que le modèle visé fonctionne correctement.
Les NPU dédiées et les accélérateurs d'IA utilisent généralement leurs propres convertisseurs de modèles, compilateurs, outils de quantification, bibliothèques d'exécution, pilotes et SDK.
Un modèle PyTorch ou un fichier ONNX ne peut donc pas nécessairement être simplement copié sur un accélérateur et exécuté.
Une conversion du modèle peut s'avérer nécessaire. Les opérateurs non pris en charge peuvent nécessiter des solutions de contournement. La quantification peut affecter la précision du modèle. Les nouvelles architectures ne bénéficient peut-être pas encore du même niveau de prise en charge que les modèles CNN éprouvés.
Le système d'exploitation joue également un rôle important. Un accélérateur performant sur le plan technique n'est pas d'une grande utilité si son environnement d'exécution ou son pilote ne prend pas en charge la distribution Linux et l'architecture du processeur utilisées par l'ordinateur de bord dédié à l'IA.
Et puis, il y a l'entretien.
Les systèmes industriels restent souvent en service pendant des années, alors que les frameworks d'IA et les architectures de modèles évoluent rapidement. Un accélérateur doté d'un SDK performant, d'un développement actif du runtime et d'exemples de déploiement documentés constitue généralement un choix plus sûr à long terme qu'un matériel aux spécifications impressionnantes mais dont l'écosystème logiciel stagne.
C'est pourquoi nous recommandons de tester le modèle réel avant de finaliser la configuration matérielle.
Pour les charges de travail liées à la vision, il convient de mesurer le pipeline complet de bout en bout plutôt que de se limiter au temps d'inférence du NPU. L'entrée de la caméra, le décodage, le prétraitement, l'inférence et le post-traitement contribuent tous à la latence.
Pour les modèles de langage à grande échelle (LLM), les indicateurs utiles comprennent le temps nécessaire pour générer le premier token, la vitesse de génération, la consommation de mémoire et les performances pour la longueur de contexte prévue.
Un véritable essai sur maquette peut en révéler davantage en un après-midi que plusieurs pages de spécifications d'accélérateur.
6. Un ordinateur dédié à l'IA en périphérie doit tout de même s'intégrer au système IT/OT
Pour un ingénieur spécialisé dans l'IIoT ou un intégrateur de systèmes, la mise en service du modèle ne marque pas la fin du projet.
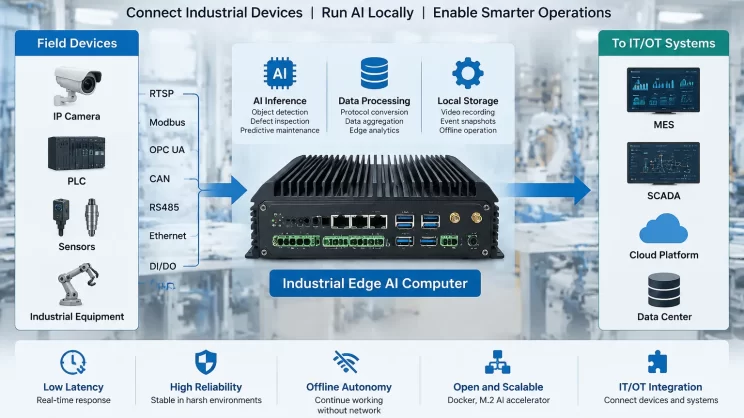
L'ordinateur d'IA en périphérie doit encore se connecter au reste du site.
Il peut s'agir d'automates programmables (PLC), de caméras, de capteurs, d'instruments, de systèmes SCADA, de plateformes MES, de bases de données locales et d'applications d'entreprise.
Les logiciels doivent eux aussi être mis à jour. Certains modèles devront peut-être être remplacés. Il faut surveiller l'état de santé du système. Les ingénieurs doivent savoir ce qui se passera en cas de coupure de la connexion WAN ou si un service d'IA cesse de répondre.
La cybersécurité et la gestion du cycle de vie font également partie intégrante de l'architecture des projets destinés aux entreprises, aux administrations publiques et aux infrastructures critiques. Le Cadre de gestion des risques liés à l'IA du NIST constitue une référence utile pour la gestion des risques liés à l'IA tout au long du cycle de vie du système.
Le nœud d'IA doit être intégré au modèle actuel de sécurité IT/OT et ne pas en être exclu.
Cela comprend la segmentation du réseau, les mises à jour logicielles contrôlées, la gestion des accès et la planification de la reprise après sinistre.
Un autre obstacle majeur dans les systèmes industriels réside dans le fait que l'inférence par IA ne doit pas constituer la seule couche décisionnelle pour les commandes critiques en matière de sécurité.
Une situation dangereuse peut être détectée par un modèle de vision. Les grands modèles de langage (LLM) sont capables d'analyser un message d'alarme ou un rapport de maintenance. Ces résultats peuvent constituer des données d'entrée utiles, mais les applications liées à la sécurité des équipements ou du personnel doivent néanmoins s'appuyer sur la logique de contrôle déterministe, les verrouillages et les mécanismes de sécurité requis.
Il s'agit là d'une différence concrète entre le déploiement de l'IA sur une carte de développement et son déploiement dans un environnement OT de production.
Un exemple concret : la puissance de calcul IA évolutive
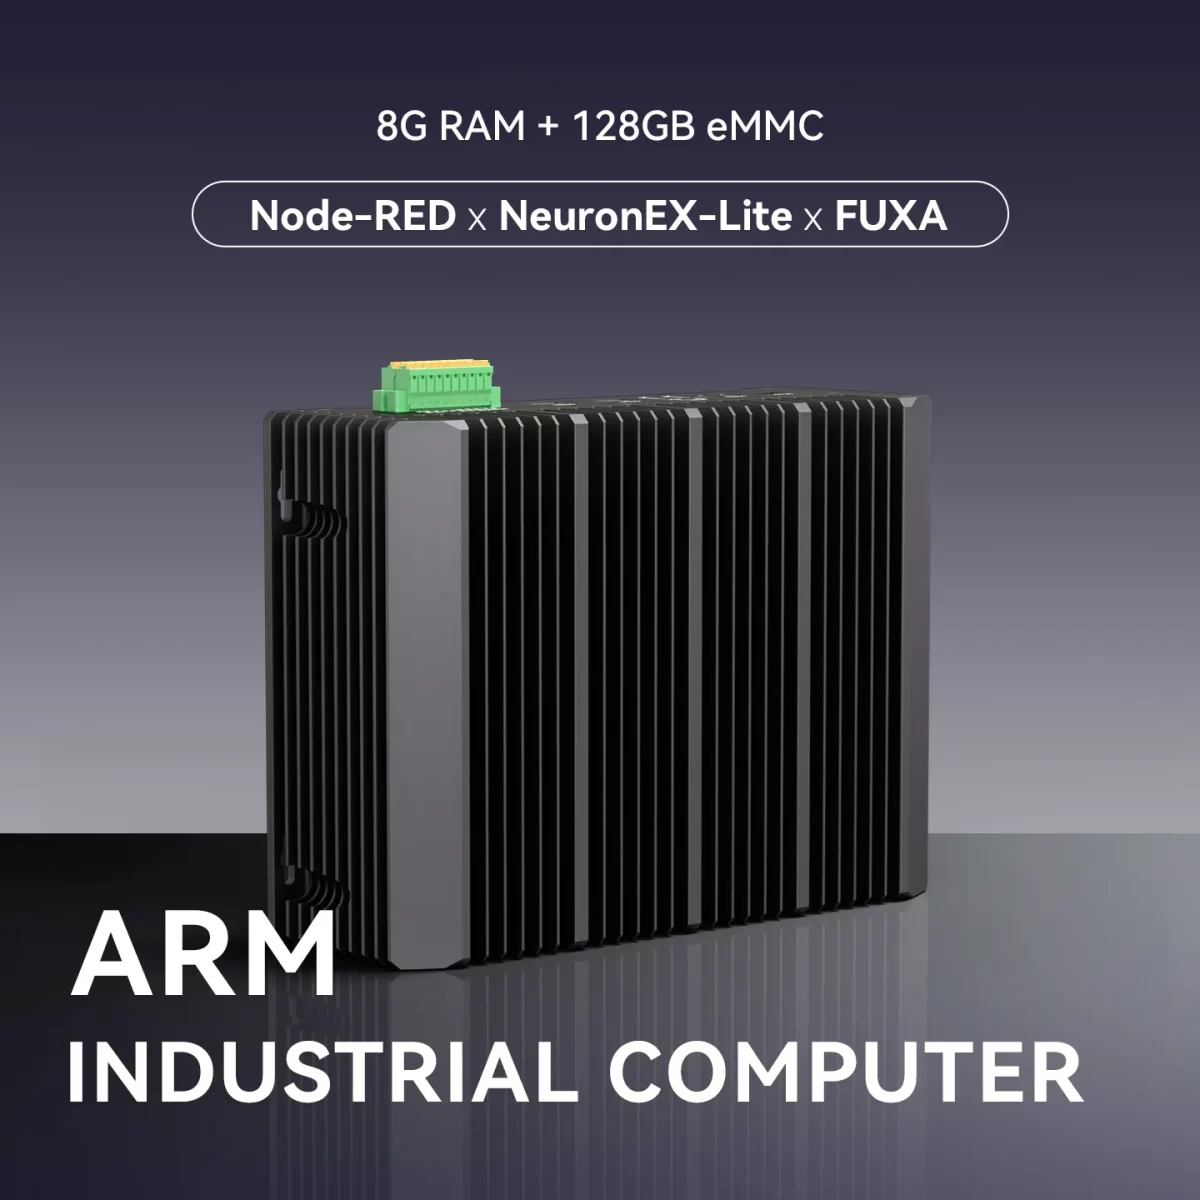
EC700 en est un exemple de cette approche évolutive. Basé sur la plateforme RK3588J, il associe un NPU intégré de 6 TOPS à deux interfaces PCIe M.2 pour une accélération IA supplémentaire, ce qui permet d'étendre les ressources de calcul à mesure que les besoins en charge de travail évoluent.
Pour les applications de vision industrielle, consultez notre guide consacré à Conception de systèmes de vision industrielle évolutifs à l'aide du RK3588J et d'accélérateurs IA M.2.
IA locale ou IA dans le cloud ?
Il n'y a pas de réponse universelle.
L'IA dans le cloud constitue souvent la solution la plus simple lorsque l'utilisation est faible, que les équipes ont besoin d'un accès rapide aux tout derniers modèles de grande envergure, ou que la gestion d'une infrastructure d'inférence locale entraînerait des coûts supplémentaires inutiles.
L'IA locale et sur site devient plus intéressante lorsque les charges de travail sont continues, que la latence est un facteur important, que la connectivité réseau ne peut être garantie, que les données sensibles doivent rester au sein de l'environnement local ou que les coûts récurrents liés aux API deviennent significatifs.
Même dans ce cas, l'inférence locale n'est pas gratuite.
Le matériel, l'alimentation électrique, le déploiement, l'adaptation des modèles, la surveillance et la maintenance ont tous un coût.
Pour de nombreux projets industriels et d'entreprise, une architecture hybride s'avère plus judicieuse que d'opter exclusivement pour l'une ou l'autre solution.
Les modèles locaux peuvent prendre en charge des charges de travail en temps réel, sensibles en matière de confidentialité ou hors ligne. Les services cloud peuvent quant à eux être utilisés pour les modèles plus volumineux, le traitement centralisé ou les charges de travail qui évoluent fréquemment.
La meilleure architecture est celle qui répond aux exigences opérationnelles.
Liste de contrôle pour le choix d'un accélérateur IA M.2
Avant d'opter pour un accélérateur IA M.2, examinez l'ensemble du système plutôt que de vous limiter à une seule valeur figurant dans la fiche technique.
| Zone | Éléments à vérifier |
|---|---|
| Charge de travail | Architecture du modèle, type d'entrée, quantification, latence ou débit cible, contexte et concurrence |
| Mémoire | Mémoire locale de l'accélérateur, bande passante mémoire et besoins réels en mémoire pendant l'exécution |
| Interface hôte | Compatibilité M.2, génération PCIe, configuration des voies et flux de données entre l'hôte et l'accélérateur |
| Énergie et thermique | Puissance nominale du module, besoins en refroidissement, température ambiante et conception thermique de l'ensemble du système |
| Logiciel | Conversion de modèles, opérateurs, exécution, pilotes, compatibilité avec les systèmes d'exploitation et maintenance du SDK |
| Intégration | Interfaces industrielles, connectivité IT/OT, mises à jour logicielles, cybersécurité et exigences relatives au cycle de vie |
| Validation | Tester le modèle réel et mesurer le nombre d'images par seconde (FPS), la latence, le temps de transit (TTFT), le nombre de jetons par seconde, l'utilisation de la mémoire et la stabilité à long terme |
En résumé
Le score TOPS peut être utile, mais il ne doit en aucun cas constituer le seul critère de choix d'un accélérateur IA M.2.
Pour les véritables projets d'IA en périphérie, il vaut mieux se demander si l'accélérateur est capable de gérer la charge de travail, s'il est compatible avec la pile logicielle et s'il peut maintenir les performances requises dans l'environnement de déploiement.
Le meilleur choix n'est pas forcément la valeur la plus élevée indiquée dans la fiche technique. C'est celle qui reste pertinente lorsque le prototype devient un système de production.
Agnes Wang est spécialiste des solutions IoT chez IOTRouter ; elle se consacre principalement aux passerelles IoT industrielles, à l'edge computing et aux solutions d'automatisation industrielle.
Elle est spécialisée dans les technologies de communication industrielle, notamment Modbus, la norme CEI 60870-5-104, MQTT, OPC UA, l'intégration d'automates programmables (PLC) et les applications de télésurveillance. Elle contribue à la rédaction d'articles techniques et de guides d'application consacrés aux solutions IoT industrielles, à la conversion de protocoles et à l'edge computing.