Naarmate edge-AI zich uitbreidt van beeldverwerking naar de lokale implementatie van LLM’s en VLM’s, worden M.2 AI-versnellers een praktische manier om extra inferentieprestaties toe te voegen aan een edge-AI-computer zonder het gehele platform te vervangen. Maar het kiezen van de juiste versneller is niet simpelweg een kwestie van het vergelijken van TOPS, geheugen, PCIe-gegevensstroom en thermisch ontwerp. Andere factoren, zoals softwarecompatibiliteit en de daadwerkelijke werklast, kunnen ook van invloed zijn op de prestaties in de praktijk. Waar let je dus echt op bij het kiezen van een M.2 AI-versneller voor edge-AI?
1. Begin met de werklast, niet met het TOPS-cijfer

Voordat je versnellingskaarten met elkaar vergelijkt, moet je eerst vaststellen wat het systeem eigenlijk moet kunnen.
Een project voor objectdetectie met één camera en een lokale implementatie van een groot taalmodel (LLM) vallen misschien allebei onder de brede categorie ‘edge-AI’, maar de hardware-eisen zijn totaal verschillend.
Bij een vision-toepassing zijn de echte vragen meestal van praktische aard. Hoeveel videostreams zijn er? Welke resolutie en beeldsnelheid zijn vereist? Waar vinden de videodecodering en -voorbewerking plaats? Wat is de aanvaardbare end-to-end-latentie?
Een LLM of VLM roept een andere reeks vragen op. De modelarchitectuur, het aantal parameters, kwantisering, de contextlengte, gelijktijdigheid en de verwachte snelheid van het genereren van tokens zijn allemaal van invloed op de hardwarevereisten.
Het aantal parameters is nuttig, maar dient slechts als een ruwe indicatie.
Een 7B-model is geen hardwarespecificatie. Twee modellen met een vergelijkbaar aantal parameters kunnen zich anders gedragen omdat hun architectuur, geheugentoegangspatronen en looptijden verschillen. Dichte modellen en Mixture-of-Experts-modellen zijn hiervan een duidelijk voorbeeld: het totale aantal parameters alleen geeft geen beeld van de rekenbelasting per token.
Kwantificering verandert het beeld opnieuw. Het verlagen van de precisie van het model kan de geheugen- en rekenvereisten aanzienlijk verminderen, maar het exacte resultaat hangt af van de manier waarop gewichten, activeringen en runtime-gegevens worden verwerkt.
Dus in plaats van te beginnen met “Hoeveel TOPS moeten we kopen?”
Een betere volgorde is: Werkbelasting → Model → Prestatiedoelstelling → Geheugen- en rekenkrachtvereisten → Hardware. Dat klinkt eenvoudig, maar het voorkomt verrassend veel verkeerde keuzes op het gebied van hardware.
2. Bij lokale LLM-implementatie kan het geheugen net zo belangrijk zijn als de rekenkracht
TOPS is van oudsher een van de belangrijkste specificaties voor AI-versnellers, met name op het gebied van computervisie.
Met LLM’s en VLM’s wordt het steeds moeilijker om het geheugen buiten beschouwing te laten.
De accelerator moet modelgewichten opslaan, maar dat is slechts een deel van de benodigde geheugencapaciteit. Ook de overhead tijdens de uitvoering, tussentijdse tensoren en de KV-cache nemen geheugen in beslag. Langere contextvensters en extra gelijktijdige gebruikers zorgen ervoor dat de benodigde geheugencapaciteit nog verder toeneemt.
Daarom kunnen twee M.2 AI-versnellers met indrukwekkende rekenprestaties toch geschikt zijn voor zeer uiteenlopende werkbelastingen.
Een kaart met relatief weinig lokaal geheugen kan goed werken voor visuele inferentie of kleinere modellen. Een kaart met veel meer versnellingsgeheugen kan een andere categorie generatieve of multimodale taken ondersteunen, mits de softwarestack het model ondersteunt.
Als de volledige werkverzameling niet in het lokale geheugen van de versneller past, betekent dat niet automatisch dat het model niet kan worden uitgevoerd. Sommige systemen kunnen gebruikmaken van ‘host-memory offloading’, het model over verschillende apparaten verdelen of andere technieken voor geheugenbeheer toepassen.
Er is echter wel een afweging.
Het verplaatsen van gegevens tussen het hostgeheugen en het versnellingsgeheugen zorgt voor extra belasting. Uitvoering op meerdere apparaten maakt de softwarearchitectuur bovendien complexer. In beide gevallen kan het model technisch gezien wel draaien, maar met een veel minder aantrekkelijke latentie of doorvoersnelheid.
Voor lokale LLM-implementatie is modelcompatibiliteit slechts het uitgangspunt. De versneller moet nog steeds voldoen aan de eisen van de toepassing op het gebied van generatiesnelheid, contextlengte en gelijktijdigheid. In de praktijk hangt dat af van de rekenkracht, het geheugen van de versneller, de geheugenbandbreedte, kwantisering en het geheugengebruik tijdens de uitvoering.
3. PCIe-bandbreedte is belangrijk, maar er is geen algemene x4-regel
De M.2-specificatie is een ander gebied waarop specificaties gemakkelijk te simplistisch kunnen worden voorgesteld.
Een M.2-sleuf geeft niet automatisch aan welke bus beschikbaar is, hoeveel PCIe-lanes er zijn aangesloten of welke PCIe-generatie wordt ondersteund. Ook de vormfactor en de fysieke compatibiliteit bieden geen garantie dat de elektrische interface overeenkomt met die van de versneller.
Dus ja, het is belangrijk om het gegevensblad van de host te raadplegen.
Maar de veelgehoorde stelling dat een krachtige AI-versneller altijd PCIe x4 moet gebruiken, is te simplistisch.
Het gaat om de gegevensstroom tussen de hostprocessor en de versneller.
Stel dat een accelerator over een eigen lokaal geheugen beschikt. Het model wordt op de accelerator geladen, het grootste deel van de inferentie vindt daar plaats, en de host verzendt voornamelijk invoergegevens en ontvangt resultaten. In die architectuur kan de hoeveelheid verkeer die via PCIe verloopt relatief beperkt zijn.
Laten we nu eens kijken naar een edge-AI-computer die meerdere camerastreams met hoge resolutie verwerkt. De videobeelden worden op de host gedecodeerd en voorbewerkt, waarna de frames continu naar de versneller worden overgedragen. De PCIe-bandbreedte wordt hierdoor veel belangrijker.
Hetzelfde geldt wanneer een deel van een model op de CPU draait en een ander deel op de versneller. Door veelvuldige overdracht van tussentijdse tensoren kunnen de vereisten voor de bandbreedte snel veranderen.
Systemen met meerdere versnellers maken het geheel nog complexer, omdat zowel de opdeling van modellen als de gegevensoverdracht tussen apparaten eveneens van invloed kunnen zijn op de prestaties.
PCIe moet daarom worden beoordeeld op basis van de daadwerkelijke gegevensstroom in het systeem, en niet alleen op basis van het TOPS-cijfer. Het gaat erom waar de gegevens vandaan komen, waar de voorbewerking plaatsvindt, waar de inferentie wordt uitgevoerd en hoeveel verkeer er tijdens het gebruik tussen de host en de versneller plaatsvindt. Deze factoren geven doorgaans een beter beeld van de kans dat PCIe een bottleneck wordt dan het aantal lanes op zich.
4. Duurzame prestaties hangen af van het stroom- en thermisch ontwerp
Een AI-accelerator werkt niet op zichzelf.
Binnenin een industriële edge-computer deelt deze de thermische omgeving met de CPU, het geheugen, de opslag, de communicatiemodules en andere elektronische componenten.
Dat is van belang omdat industriële installaties zelden dezelfde koelomstandigheden bieden als een laboratoriumwerkbank of een server in een datacenter.
Edge AI-computers kunnen worden geïnstalleerd in schakelkasten, apparatuurbehuizingen, productiemachines, wegkantkasten of andere ruimtes met een beperkte luchtstroom. In deze omgevingen is een korte benchmark niet noodzakelijkerwijs representatief voor de prestaties op de lange termijn.
Naarmate de temperatuur stijgt, kan een processor of versneller zijn werkfrequentie verlagen om binnen de thermische limieten te blijven. De theoretische TOPS-waarde is niet veranderd, maar de daadwerkelijke inferentie-doorvoer kan afnemen.
Het effect wordt groter naarmate het vermogen van de versneller toeneemt of wanneer er meer dan één rekenmodule is geïnstalleerd.
Om die reden moeten het vermogens- en het thermische ontwerp op systeemniveau worden beoordeeld.
Kijk niet alleen naar het nominale vermogen van de versneller. Houd ook rekening met de CPU, de AI-module, de opslag, de mobiele modem en andere componenten die mogelijk tegelijkertijd actief zijn. De specificaties voor de bedrijfstemperatuur en de koelingsvereisten van de module zelf moeten ook afzonderlijk worden gecontroleerd, los van de temperatuurclassificatie van de basiscomputer.
Een configuratie met twee versnellers biedt weliswaar twee keer zoveel theoretische AI-rekenkracht als een configuratie met één kaart, maar dat betekent niet automatisch dat het volledige systeem bij elke omgevingstemperatuur twee keer zoveel inferentieprestaties zal leveren.
Voor een echt industrieel AI-project is langdurig testen onder de verwachte werklast en in de verwachte omgeving nuttiger dan een korte benchmark waarbij de piekprestaties worden gemeten.
5. De softwarestack is vaak bepalend voor de integratietijd
Dit is een van de aspecten bij de keuze van een AI-accelerator die het gemakkelijkst over het hoofd wordt gezien.
De hardware is binnen enkele minuten geïnstalleerd. Het kan echter veel langer duren om het beoogde model goed te laten werken.
Speciale NPU’s en AI-versnellers maken doorgaans gebruik van hun eigen modelconverters, compilers, kwantisatietools, runtime-bibliotheken, stuurprogramma’s en SDK’s.
Een PyTorch-model of ONNX-bestand is daarom niet per se iets dat zomaar naar een versneller kan worden gekopieerd en daar kan worden uitgevoerd.
Het kan zijn dat het model moet worden geconverteerd. Voor niet-ondersteunde operatoren zijn mogelijk tijdelijke oplossingen nodig. Kwantisering kan de nauwkeurigheid van het model beïnvloeden. Nieuwe architecturen worden mogelijk nog niet in dezelfde mate ondersteund als volwassen CNN-modellen.
Ook het besturingssysteem speelt een rol. Een technisch geavanceerde versneller heeft weinig nut als de runtime of het stuurprogramma ervan geen ondersteuning biedt voor de Linux-distributie en de CPU-architectuur die door de betreffende edge-AI-computer worden gebruikt.
Dan is er nog het onderhoud.
Industriële systemen blijven vaak jarenlang in gebruik, terwijl AI-frameworks en modelarchitecturen snel veranderen. Een accelerator met een degelijke SDK, actieve ontwikkeling van de runtime en gedocumenteerde implementatievoorbeelden is doorgaans een veiligere keuze voor de lange termijn dan hardware met indrukwekkende specificaties maar een stilstaand software-ecosysteem.
Daarom raden we aan om het daadwerkelijke model te testen voordat de hardwareconfiguratie definitief wordt vastgesteld.
Meet bij vision-workloads de daadwerkelijke end-to-end-pijplijn in plaats van alleen de inferentietijd van de NPU. De camera-input, decodering, voorbewerking, inferentie en nabewerking dragen allemaal bij aan de latentie.
Voor LLM’s zijn nuttige meetwaarden onder meer de tijd tot het eerste token, de generatiesnelheid, het geheugenverbruik en de prestaties bij de beoogde contextlengte.
Een echte modelproef kan in één middag meer informatie opleveren dan meerdere pagina’s met specificaties van de versneller.
6. Een Edge AI-computer moet nog steeds in het IT/OT-systeem passen
Voor een IIoT-ingenieur of systeemintegrator is het in bedrijf stellen van het model niet het einde van het project.
De edge-AI-computer moet nog steeds verbinding maken met de rest van de locatie.
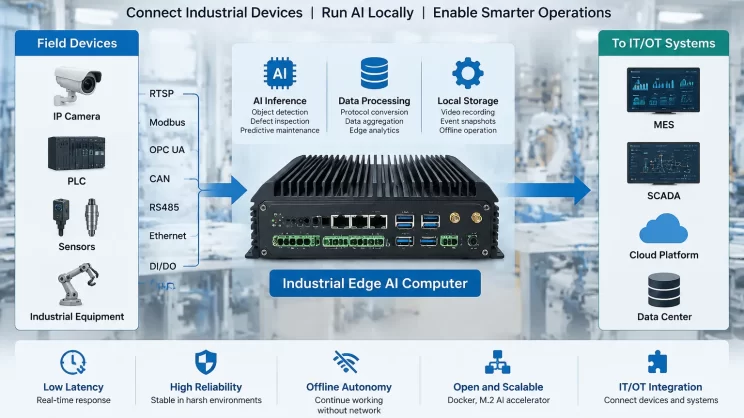
Dit kunnen PLC’s, camera’s, sensoren, meetinstrumenten, SCADA-systemen, MES-platforms, lokale databases en bedrijfsapplicaties zijn.
Ook de software moet worden bijgewerkt. Modellen moeten mogelijk worden vervangen. De systeemstatus moet worden gecontroleerd. Technici moeten weten wat er gebeurt als de WAN-verbinding wegvalt of een AI-dienst niet meer reageert.
Cyberbeveiliging en levenscyclusbeheer maken ook deel uit van de architectuur voor projecten in het bedrijfsleven, bij de overheid en op het gebied van kritieke infrastructuur. De NIST-raamwerk voor risicobeheer op het gebied van kunstmatige intelligentie biedt een nuttig naslagwerk voor het beheer van AI-gerelateerde risico’s gedurende de gehele levenscyclus van het systeem.
Het AI-knooppunt moet worden geïntegreerd in het huidige IT/OT-beveiligingsmodel en mag daar niet buiten vallen.
Dat omvat netwerksegmentatie, gecontroleerde software-updates, toegangsbeheer en herstelplanning.
Een andere belangrijke beperking in industriële systemen is dat AI-inferentie niet de enige beslissingslaag mag zijn voor veiligheidskritische besturing.
Een onveilige situatie kan door een beeldverwerkingsmodel worden gedetecteerd. Een LLM kan een alarm- of onderhoudsrapport interpreteren. Deze resultaten kunnen als nuttige input dienen, maar bij toepassingen waarbij de veiligheid van apparatuur of personeel in het geding is, moet men nog steeds vertrouwen op de vereiste deterministische besturingslogica, vergrendelingen en veiligheidsmechanismen.
Dit is een praktisch verschil tussen het implementeren van AI op een ontwikkelingsbord en het implementeren van AI in een OT-productieomgeving.
Een praktisch voorbeeld: schaalbare AI-rekenkracht
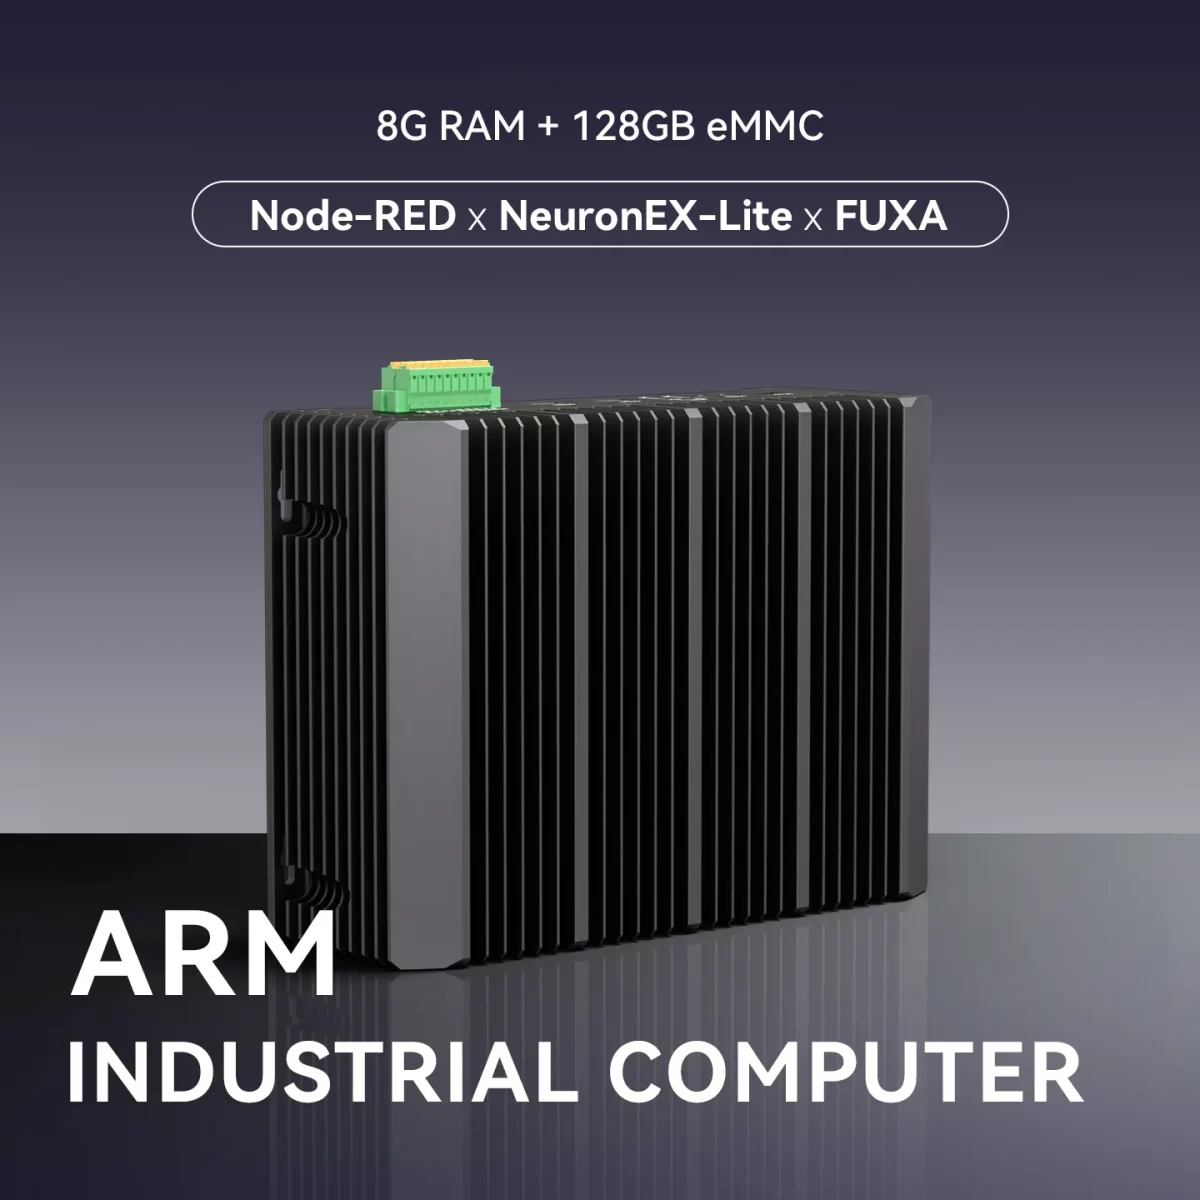
EC700 is een voorbeeld van deze schaalbare aanpak. Het is gebaseerd op het RK3588J-platform en combineert een geïntegreerde NPU van 6 TOPS met twee M.2 PCIe-interfaces voor extra AI-versnelling, waardoor de rekenkracht kan worden uitgebreid naarmate de eisen van de werklast veranderen.
Voor toepassingen op het gebied van machine vision kunt u onze gids raadplegen over het bouwen van uitbreidbare industriële beeldverwerkingssystemen met de RK3588J en M.2 AI-versnellers.
Lokale AI of AI in de cloud?
Er is geen algemeen geldend antwoord.
Cloud-AI is vaak de eenvoudigere keuze wanneer het gebruik beperkt is, teams snel toegang moeten hebben tot de nieuwste grote modellen, of wanneer het onderhouden van lokale infrastructuur voor inferentie onnodige kosten met zich mee zou brengen.
Lokale en on-premises AI wordt aantrekkelijker wanneer er sprake is van continue workloads, latentie een rol speelt, netwerkconnectiviteit niet kan worden gegarandeerd, gevoelige gegevens binnen de lokale omgeving moeten blijven of terugkerende API-kosten aanzienlijk worden.
Maar zelfs dan is lokale inferentie niet gratis.
Hardware, stroomvoorziening, implementatie, modelaanpassing, monitoring en onderhoud brengen allemaal kosten met zich mee.
Voor veel industriële en bedrijfsprojecten is een hybride architectuur een betere keuze dan uitsluitend voor één van beide opties te kiezen.
Lokale modellen zijn geschikt voor realtime, privacygevoelige of offline taken. Clouddiensten kunnen nog steeds worden gebruikt voor grotere modellen, gecentraliseerde verwerking of taken die regelmatig veranderen.
De beste architectuur is degene die aansluit bij de operationele vereisten.
Checklist voor de keuze van een M.2 AI-versneller
Voordat je een M.2 AI-versneller aanschaft, moet je het volledige systeem beoordelen in plaats van alleen naar één getal op het gegevensblad te kijken.
| Gebied | Wat moet je controleren? |
|---|---|
| Werkdruk | Modelarchitectuur, invoertype, kwantisering, beoogde latentie of doorvoercapaciteit, context en gelijktijdigheid |
| Geheugen | Accelerator-lokaal geheugen, geheugenbandbreedte en daadwerkelijke geheugenbehoefte tijdens de uitvoering |
| Hostinterface | M.2-compatibiliteit, PCIe-generatie, lane-configuratie en gegevensstroom tussen host en versneller |
| Energie en thermische energie | Continu vermogen van de module, koelingsvereisten, omgevingstemperatuur en thermisch ontwerp van het volledige systeem |
| Software | Modelconversie, operators, runtime, stuurprogramma’s, compatibiliteit met besturingssystemen en SDK-onderhoud |
| Integratie | Industriële interfaces, IT/OT-connectiviteit, software-updates, cyberbeveiliging en levenscyclusvereisten |
| Validatie | Test het daadwerkelijke model en meet de FPS, latentie, TTFT, tokens per seconde, geheugengebruik en de blijvende stabiliteit |
Conclusie
TOPS kan nuttig zijn, maar mag nooit het enige criterium zijn bij het kiezen van een M.2 AI-versneller.
Bij echte edge-AI-projecten is het beter om je af te vragen of de accelerator de werklast aankan, compatibel is met de softwarestack en de vereiste prestaties kan leveren in de implementatieomgeving.
De beste keuze is niet het hoogste getal op het gegevensblad. Het is degene die nog steeds zinvol is wanneer het prototype een productiesysteem wordt.
Agnes Wang is IoT-oplossingsspecialist bij IOTRouter en richt zich op industriële IoT-gateways, edge computing en oplossingen voor industriële automatisering.
Ze is gespecialiseerd in industriële communicatietechnologieën, waaronder Modbus, IEC 60870-5-104, MQTT, OPC UA, PLC-integratie en toepassingen voor monitoring op afstand. Ze levert bijdragen aan technische artikelen en toepassingsgidsen over industriële IoT-oplossingen, protocolconversie en edge computing.