Un ordinateur industriel d'IA en périphérie est une plateforme d'informatique en périphérie conçue pour être déployée dans des environnements industriels. Il effectue localement des opérations d'inférence d'IA, de traitement des données, de conversion de protocoles et de prise de décision en temps réel. Par rapport aux solutions dépendantes du cloud, il réduit la dépendance à la connectivité réseau et améliore la vitesse de réponse pour les applications industrielles.
Ce guide s'adresse aux ingénieurs, aux intégrateurs de systèmes et aux équipes techniques chargées d'évaluer les options de déploiement de l'IA industrielle en périphérie. Du point de vue des pratiques d'ingénierie, il aborde l'architecture système, l'évaluation des ressources matérielles, l'analyse des charges de travail d'IA, les tests de résistance et les méthodes de réception sur site pour les ordinateurs industriels dédiés à l'IA en périphérie, contribuant ainsi à réduire les risques tels que l'insuffisance de puissance de calcul, les fluctuations de performances et l'instabilité à long terme du fonctionnement.
1. Architecture technique globale d'un ordinateur industriel dédié à l'IA en périphérie
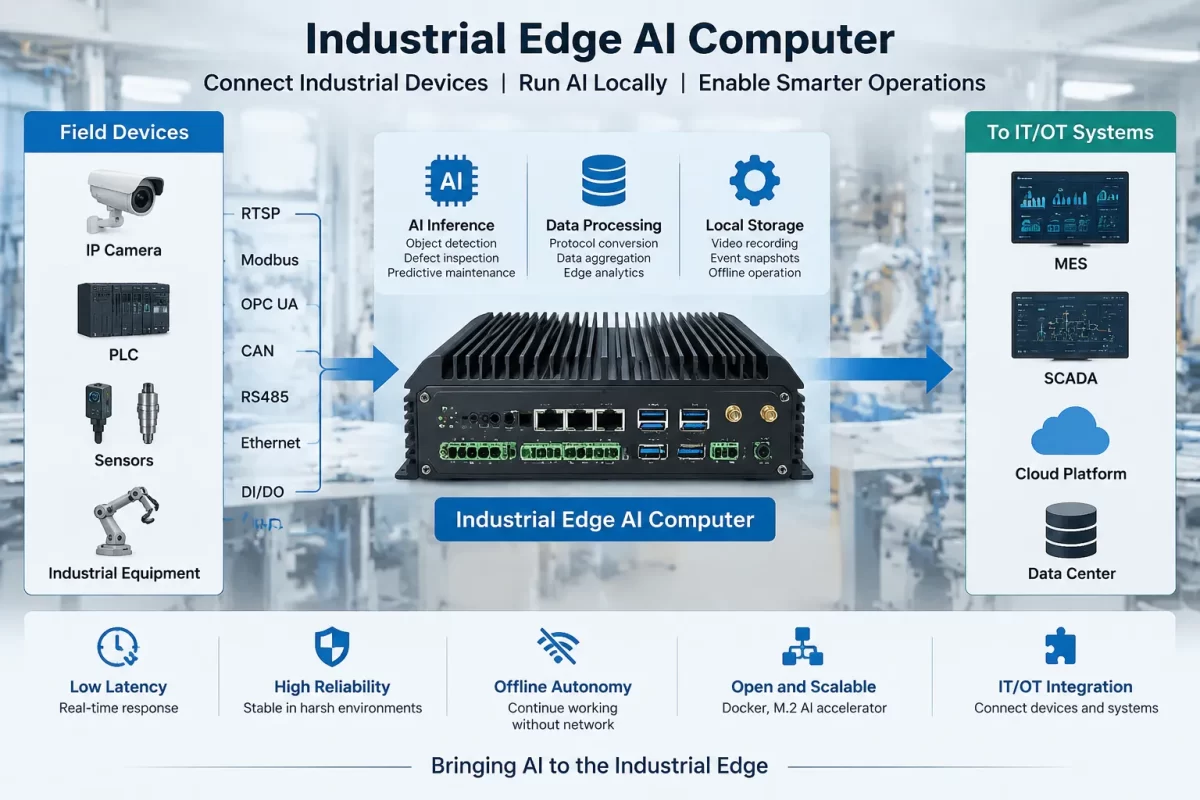
Le positionnement principal d'un ordinateur industriel doté d'une intelligence artificielle de pointe à savoir : connectivité des appareils industriels + informatique en périphérie + inférence IA + déploiement d'applications locales + convergence IT/OT.
Contrairement aux approches basées sur le cloud, un ordinateur industriel dédié à l'IA en périphérie (edge) concentre la puissance de calcul sur le site même, effectuant localement le traitement des données, l'inférence IA et la logique métier. Cela permet de réduire la charge sur le réseau et d'améliorer la fiabilité du système dans des environnements réseau caractérisés par une faible latence, une bande passante réduite et une instabilité.
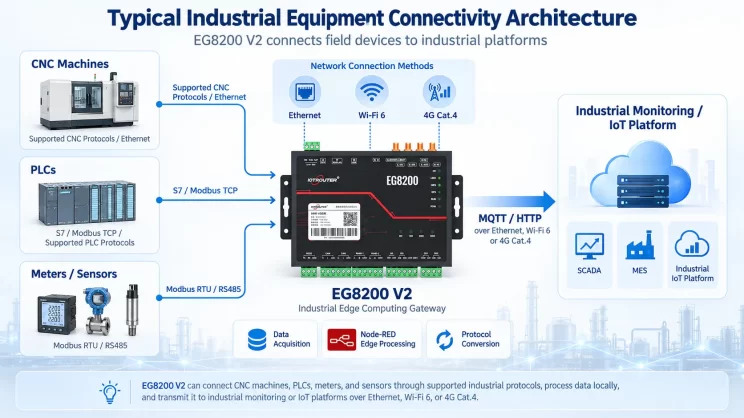
Architecture type : Appareil industriel / Capteur / Caméra → Ordinateur industriel dédié à l'IA en périphérie → Traitement des données + Inférence IA + Application locale → MES / SCADA / Plateforme cloud.
1.1 Architecture matérielle en couches
1. Couche de connectivité
Sources de données industrielles : Automates programmables, équipements à commande numérique, robots, capteurs industriels, systèmes de vision et autres équipements de terrain.
Accès aux données : Se connecter aux appareils de terrain via des protocoles de communication industriels tels que RS485, CAN FD et Ethernet afin d'obtenir l'état des équipements, les données de production, les informations des capteurs et les données opérationnelles.
Réseau : Utilisez les réseaux Ethernet, Wi-Fi, 4G/5G et d'autres méthodes de connexion pour assurer la connectivité des appareils, l'accès à distance et l'échange de données entre les systèmes industriels.
2. Couche de calcul (noyau)
Processeur : Gère le fonctionnement du système d'exploitation, le traitement des données industrielles, les communications réseau, l'analyse des protocoles et la gestion des services applicatifs.
NPU : Il prend généralement en charge les principales tâches d'inférence IA, mais le goulot d'étranglement réel du système ne se limite pas nécessairement au calcul IA. Il peut également être influencé par la planification des tâches du processeur, le décodage vidéo, la bande passante mémoire et l'efficacité du transfert de données.
Mémoire (RAM) : Utilisé pour l'exploitation du système Linux, le chargement de modèles d'IA, la mise en cache des données et le déploiement de plusieurs applications.
Stockage (eMMC/SSD) : Utilisé pour les fichiers système, les modèles d'IA, les bases de données, les applications et le stockage de données industrielles afin de répondre aux exigences de fonctionnement à long terme.
3. Couche de sortie
En amont : Transmettez des alertes, des instantanés et des données structurées vers des plateformes cloud via MQTT/HTTP/HTTPS.
Sortie locale : Sortie E/S d'alarme, pages Web locales et bases de données locales.
1.2 Architecture logicielle en couches (couramment utilisée dans les déploiements d'ingénierie)
Couche applicative métier : Permet d'exécuter des applications industrielles, des algorithmes d'IA, des analyses de données locales et des programmes définis par l'utilisateur.
├─Couche d'inférence IA : Déploie des modèles de vision, des modèles d'apprentissage automatique ou d'autres applications d'IA en périphérie en fonction des capacités matérielles et des exigences des applications. Selon l'environnement de déploiement et la plateforme matérielle, des moteurs d'inférence tels que ONNX Runtime peut être utilisé pour optimiser l'exécution des modèles dans différents environnements.
├─ Couche intermédiaire : Fournit l'environnement d'exécution de l'application en fonction des besoins du projet, tels que Conteneurs Docker, des bases de données, des services de communication MQTT ou des services de données industrielles.
├─ Couche système : Le système d'exploitation Linux gère les ressources du système, les communications réseau et le fonctionnement des périphériques.
└─ Couche des pilotes matériels : Pilotes NPU, ports réseau et pilotes de périphériques d'E/S.
Pour les scénarios nécessitant l'exécution locale de modèles LLM/VLM, il convient d'évaluer plus en détail la capacité mémoire et les capacités d'accélération IA. Il ne faut pas partir du principe que tous les ordinateurs IA en périphérie sont adaptés à ce type de charge de travail.
Deux modes de déploiement
-
Mode intégré au micrologiciel : L'environnement système et les applications sont préconfigurés, ce qui rend cette solution adaptée aux scénarios d'utilisation standardisés.
-
Déploiement en conteneurs Docker : Les modèles d'IA, les bases de données, les logiciels de gestion et les services industriels s'exécutent dans des conteneurs distincts. Cela facilite les mises à jour indépendantes des applications et le développement secondaire, et convient à un déploiement industriel à long terme.
1.3 Flux de données type
Déroulement type d'une application industrielle :
Automate programmable / Capteur / Caméra / Équipement industriel
 ↓
Acquisition de données
 ↓
Conversion de protocole + Traitement local
 ↓
Inférence IA + Logique métier
 ↓
Application locale
 ↓
MES / SCADA / Plateforme cloud
Par exemple, dans le domaine de la fabrication intelligente, un ordinateur doté d'une intelligence artificielle (IA) dédié à la fabrication intelligente peut recevoir des données d'exécution provenant d'automates programmables (PLC), des informations sur l'état des équipements et des données de vision, effectuer localement le traitement des données et l'analyse par IA, puis synchroniser les résultats avec un système MES, un système SCADA ou une plateforme cloud industrielle.
Piège technique majeur : Les performances d'un ordinateur industriel dédié à l'IA en périphérie ne peuvent pas être évaluées uniquement en fonction du TOPS. Dans les déploiements réels, la puissance de calcul du processeur, la capacité de mémoire, l'écosystème logiciel, les capacités d'extension en matière d'IA et la stabilité à long terme du fonctionnement influent toutes sur les performances finales de l'application.
2. Méthode d'évaluation des charges de travail des ordinateurs industriels dotés d'IA en périphérie (présélection visant à éviter les performances insuffisantes)
L'évaluation de la charge de travail d'un ordinateur industriel dédié à l'IA en périphérie a pour objectif de déterminer si l'appareil est capable de répondre aux exigences de calcul du projet concerné.
Contrairement aux serveurs traditionnels, les appareils d’edge computing doivent généralement assurer simultanément la communication entre appareils, le traitement des données, l’inférence IA et l’exécution d’applications locales, tout en fonctionnant avec une alimentation limitée et dans des conditions environnementales industrielles. Par conséquent, lors de leur sélection, il ne suffit pas de se limiter aux seuls paramètres de calcul IA. Il faut également prendre en compte les performances du processeur, la taille des modèles d’IA, les ressources mémoire, les besoins en stockage et l’environnement d’exécution logiciel.
Les principaux critères d'évaluation sont les suivants : le volume des données industrielles, la complexité des tâches d'IA, le nombre d'applications exécutées simultanément, l'utilisation de la mémoire et les besoins en puissance de calcul supplémentaire.
2.1 Paramètres d'entrée relatifs à la charge de travail de l'entreprise (à confirmer avant la conception de la solution)
Au cours de la phase d'évaluation du projet, la première étape consiste à définir clairement les types de données, les types de tâches d'IA et l'environnement d'exécution que l'appareil doit prendre en charge.
Les différents scénarios d'application présentent des besoins en ressources de calcul très variés. Par exemple, l'acquisition de données industrielles, l'analyse par vision, l'exécution de modèles d'IA en local et le déploiement multiservices ont des exigences différentes en matière de ressources CPU, de calcul IA et de mémoire.
Par ailleurs, il convient de vérifier si l'appareil doit exécuter plusieurs services d'application, tels que Docker, des bases de données, des services de communication et des programmes définis par l'utilisateur, afin de disposer d'une base pour le choix ultérieur du matériel.
2.2 Méthode pratique d'estimation de la charge de travail (estimation technique rapide)
La charge de travail réelle d'un ordinateur industriel dédié à l'IA en périphérie n'est pas déterminée uniquement par les calculs d'IA. Elle dépend à la fois de la puissance de traitement du processeur, des tâches d'inférence d'IA, des ressources mémoire et du volume de données traitées.
Tout d’abord, il convient d’évaluer la charge de travail du processeur (CPU). Outre l’exécution de modèles d’IA, un dispositif d’edge computing doit également gérer le système Linux, l’analyse des protocoles industriels, les communications réseau, les services Docker et le fonctionnement des programmes métier. Si un projet exécute simultanément l’acquisition de données d’automate programmable (PLC), la communication MQTT, une base de données et des applications d’IA, la consommation de ressources du processeur augmentera considérablement. Par conséquent, lors de la sélection, il ne suffit pas de se concentrer uniquement sur les performances du NPU. Des tests d’exécution réels sont nécessaires pour vérifier l’utilisation du processeur et la réactivité du système.
La charge de calcul liée à l'inférence IA dépend principalement de la complexité du modèle, du volume des données d'entrée, de la fréquence d'inférence et du nombre de tâches exécutées simultanément. Par exemple, dans les applications de vision, la résolution, le nombre d'images par seconde (FPS) et le nombre de flux vidéo ont une incidence directe sur la consommation de ressources de calcul. Un modèle de vision léger et un LLM local peuvent présenter des besoins en ressources de calcul et en mémoire totalement différents, même lorsqu'ils s'exécutent sur le même matériel IA.
L'évaluation technique doit généralement prendre en compte à la fois la complexité de la tâche d'IA, le volume des données d'entrée, la fréquence des inférences et la concurrence. Toutefois, cette relation ne peut servir qu'à une estimation préliminaire. Les performances réelles doivent encore être confirmées par des tests de performance réalisés avec le modèle cible.
Par ailleurs, la mémoire et le stockage constituent également des facteurs clés dans le déploiement de l'IA en périphérie. L'appareil doit charger des modèles d'IA, exécuter des services Docker, gérer des bases de données et mettre en cache des données industrielles, le tout simultanément. Par conséquent, la capacité de la mémoire vive (RAM) et les performances de stockage ont une incidence directe sur la stabilité du système.
Pour des applications telles que les modèles LLM/VLM locaux, la taille du modèle constitue généralement le principal facteur limitant. Il n'est pas possible de déterminer si un appareil répond aux exigences en se basant uniquement sur le nombre de TOPS.
Remarque : La puissance de calcul théorique ne correspond pas aux capacités réelles en milieu d'entreprise. Les TOPS ne reflètent pas les performances réelles de l'IA industrielle. Lors du choix d'un matériel d'accélération IA, il convient également de prendre en compte des facteurs tels que la bande passante mémoire, l'interface PCIe, la conception thermique et la prise en charge logicielle. Consultez notre guide sur [Sélection d'un accélérateur IA M.2].
Le TOPS nominal d'une puce correspond à la puissance de calcul maximale idéale. Dans la pratique, les applications industrielles sont également influencées par l'optimisation des modèles, les frameworks logiciels, l'efficacité de l'accès à la mémoire, le transfert de données et les conditions thermiques.
Par conséquent, le choix des appareils industriels d'IA en périphérie doit se fonder sur les résultats réels des tests de performance, et non pas simplement sur les caractéristiques techniques des puces.
2.3 Risques courants liés à la charge de travail
Dans les projets d'IA en périphérie industrielle, le problème le plus courant n'est généralement pas le manque de puissance de calcul pour l'IA, mais une planification insuffisante des ressources système.
Par exemple, se concentrer uniquement sur les performances du NPU tout en négligeant la charge du CPU peut entraîner une dégradation des temps de réponse lorsque l'appareil gère des services de communication et d'applications industrielles.
Lorsque plusieurs services Docker, bases de données et modèles d'IA s'exécutent simultanément, un manque de mémoire peut également nuire à la stabilité du système.
De plus, les applications d'IA voient généralement l'échelle de leurs modèles augmenter à mesure que les projets évoluent. L'appareil doit donc disposer d'une certaine marge de manœuvre en termes de puissance de calcul et d'évolutivité afin d'éviter de devoir remplacer le matériel lors de mises à niveau ultérieures.
2.4 Guide de sélection du matériel
Les applications industrielles « légères » portent principalement sur la connectivité des appareils, le traitement des données et des tâches simples d'intelligence artificielle. Ces scénarios nécessitent généralement une plateforme informatique industrielle stable et des capacités de base en matière d'intelligence artificielle.
Pour applications de l'IA dans le domaine de la vision industrielle, l'analyse locale par IA et le fonctionnement parallèle de plusieurs applications, un ordinateur industriel dédié à l'IA, destiné à la vision artificielle ou à des charges de travail similaires, nécessite un processeur (CPU) et un processeur de traitement des données neuronales (NPU) plus performants, ainsi que davantage de ressources mémoire.
Si le projet fait également appel à des automates programmables (PLC), à des capteurs ou à la connectivité d'équipements industriels, il convient également de prendre en compte la compatibilité avec les interfaces de communication industrielles telles que RS485, CAN, Ethernet, ainsi qu'avec d'autres protocoles.
Si l'application fait appel à des modèles LLM/VLM locaux, à l'inférence parallèle multimodèle ou à des calculs d'IA complexes, il convient d'étudier plus en détail les possibilités d'extension de l'accélération IA, par exemple en passant à un module IA plus performant via une interface PCIe M.2.
3. Tests de résistance techniques (validation de la charge, obligatoires avant la mise en production)
Le fait de pouvoir exécuter un modèle d'IA dans un environnement de laboratoire ne signifie pas pour autant que l'appareil soit nécessairement adapté à un déploiement industriel concret.
Lorsqu'un ordinateur « edge AI » fonctionne sur site, il doit généralement gérer des tâches de calcul variables, des fluctuations du réseau, plusieurs applications simultanées et un fonctionnement à long terme. C'est pourquoi, avant tout déploiement officiel, la puissance de calcul et la stabilité de l'appareil doivent être testées dans des scénarios d'exploitation réels.
L'objectif de la validation n'est pas de tester les performances théoriques maximales de l'appareil, mais de vérifier si celui-ci est capable de répondre aux exigences en matière de performances en temps réel, de stabilité et d'évolutivité sous la charge d'application cible.
3.1 Préparation de l'environnement de test
L'environnement de test doit être aussi proche que possible des conditions réelles d'utilisation de l'application.
Lors de la validation, il est recommandé d'utiliser l'environnement logiciel réel correspondant au scénario cible, c'est-à-dire le même système d'exploitation, le même modèle d'IA, le même cadre d'inférence et les mêmes applications.
Parallèlement, il est nécessaire de surveiller l'état de fonctionnement de l'appareil, notamment l'utilisation du processeur, de la mémoire, des ressources de calcul IA, les opérations de lecture/écriture sur le stockage et le temps de réponse des tâches, afin de déterminer si l'appareil présente des goulots d'étranglement au niveau des ressources.
3.2 Tests de charge de travail métier
Les performances d'un dispositif d'IA en périphérie doivent être évaluées en fonction des tâches réelles.
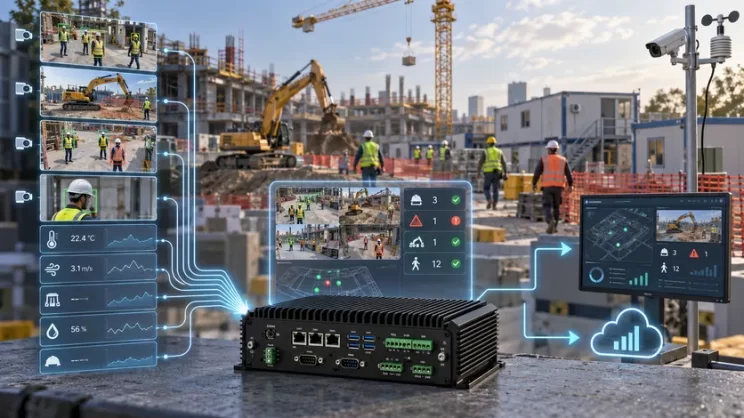
Par exemple, les chantiers intelligents peuvent se concentrer sur la réactivité en temps réel pour les tâches d’analyse visuelle ; l'inspection des panneaux photovoltaïques peut se concentrer sur le traitement d'images et la capacité d'inférence des modèles ; la fabrication industrielle intelligente peut se concentrer à la fois sur l'accès aux données des appareils, le calcul local et l'analyse par IA ; la surveillance transparente des cuisines et l'analyse de sécurité par IA se concentrent généralement davantage sur la gestion simultanée de flux vidéo multicanaux, les performances en temps réel des alarmes et la stabilité de fonctionnement à long terme.
Lors des tests, il convient d'exécuter l'ensemble du flux de travail conformément au processus métier réel, plutôt que de se contenter de tester le modèle d'IA seul. L'essentiel est de vérifier si l'inférence de l'IA reste stable, si le système fonctionne sans heurts en mode multitâche, si le traitement des données entraîne une latence et si les services applicatifs peuvent continuer à fonctionner dans la durée.
3.3 Essais de fonctionnement de longue durée
Les appareils d'IA en périphérie sont souvent déployés dans des environnements sans surveillance ; il convient donc d'accorder une attention particulière à la fiabilité de leur fonctionnement à long terme.
Pendant les essais, vérifiez si l'appareil présente les caractéristiques suivantes en fonctionnement continu :
-
Augmentation continue de la mémoire ;
-
Fermeture anormale de l'application ;
-
Baisse des performances d'inférence ;
-
Réponse plus lente du système.
Les tests d'exécution de longue durée ont pour objectif de mettre en évidence les problèmes qui ne peuvent pas être détectés lors d'une phase de démonstration de courte durée.
3.4 Tests en conditions environnementales anormales
Les conditions réelles sur site ne sont pas toujours idéales.
Avant la mise en service, il convient de vérifier la capacité de reprise de l'appareil en cas de conditions anormales, par exemple :
-
La communication est-elle rétablie après une interruption temporaire du réseau ? ;
-
Si les services d'application peuvent redémarrer après une fermeture anormale ;
-
Vérifier si les mécanismes de mise en cache et de synchronisation des données fonctionnent correctement.
Ce type de tests permet de déterminer si l'appareil est adapté à une mise en service à long terme, et pas seulement à une utilisation en laboratoire.
3.5 Évaluation des résultats des tests
Lors du choix d'un appareil d'IA en périphérie, il convient de se concentrer sur la capacité de l'appareil à répondre aux besoins réels de l'entreprise, et non pas simplement de comparer les paramètres relatifs au CPU, au NPU ou au TOPS.
Une plateforme informatique d'IA en périphérie adaptée à un déploiement industriel doit offrir une marge de calcul suffisante, un environnement d'exécution logiciel stable, une bonne capacité d'extension et une fiabilité d'exécution à long terme dans le cadre de la charge de travail visée.
3.6 Référence sur les indicateurs de validation recommandés
Les indicateurs suivants peuvent servir de référence pour les tests de résistance et la validation de la sélection. Les seuils spécifiques doivent être ajustés en fonction de la charge réelle du projet et des capacités de la plateforme.
| Système métrique | Axe de validation |
|---|---|
| UNITÉ CENTRALE | Qu'il reste saturé pendant de longues périodes au cours de l'activité de l'entreprise |
| Mémoire | S'il s'agit d'une augmentation continue ou d'une fuite |
| Inférence IA | La latence reste-t-elle stable ? |
| Stockage | Les écritures en continu constituent-elles un phénomène anormal ? |
| Réseau | La reprise après déconnexion fonctionne-t-elle normalement ? |
| Durée d'exécution | Fonctionnement stable pendant 72 heures ou plus |
4. Méthode de réception des projets sur site
Une fois l'évaluation de la charge de travail et les tests de résistance préalables au déploiement terminés, la réception sur site sert principalement à vérifier si l'ordinateur industriel de pointe dédié à l'IA a bien été déployé conformément au plan de conception et à s'assurer que l'appareil, les logiciels et les systèmes métier sont correctement connectés.
Contrairement aux tests de performance décrits précédemment, les tests de réception sur site portent principalement sur la cohérence du déploiement dans l'environnement réel, notamment la configuration matérielle, l'environnement logiciel, les liaisons de données et l'état d'exécution des applications.
4.1 Vérification de l'environnement matériel et logiciel
Lors du déploiement sur site, veillez tout d'abord à ce que la configuration réelle de l'appareil corresponde au plan de conception, notamment en ce qui concerne la plateforme de calcul, la mémoire, le stockage et la configuration de l'accélération IA.
Parallèlement, enregistrez les informations relatives à l'environnement d'exécution du logiciel, telles que la version du système Linux, le framework d'inférence IA, la version de l'application et la configuration du conteneur Docker.
Ces informations constituent une base importante pour la maintenance et le dépannage ultérieurs de l'appareil. En particulier lors de l'exploitation à long terme de projets industriels, les mises à jour de version logicielle peuvent avoir une incidence sur le fonctionnement de l'appareil et la compatibilité des applications.
4.2 Ingestion des données et validation des processus métier
Un ordinateur industriel d'IA en périphérie doit, en fin de compte, répondre aux besoins d'un processus métier spécifique ; c'est pourquoi la validation sur site doit s'articuler autour du flux de données dans son intégralité.
Par exemple, dans le domaine de l'automatisation industrielle, un ordinateur d'IA en périphérie destiné à l'automatisation industrielle doit s'assurer que les données provenant des automates programmables (PLC), des capteurs ou d'autres appareils peuvent être transmises normalement au nœud de calcul en périphérie, et que leur traitement et leur transfert s'effectuent conformément au flux de travail prévu.
Dans les scénarios d'application de l'IA, il est nécessaire de vérifier que le modèle se charge correctement, que les résultats d'inférence répondent aux exigences de la logique métier et que l'échange de données avec les systèmes de niveau supérieur fonctionne correctement.
En cas d'utilisation de Docker ou d'autres méthodes de déploiement en conteneurs, il convient également de vérifier les dépendances et la communication entre les services applicatifs.
4.3 Confirmation de l'état de fonctionnement du système
Lors de l'exploitation sur site, vérifiez que l'appareil fonctionne de manière stable dans les conditions réelles du réseau et de l'environnement industriel.
Concentrez-vous sur les journaux d'exécution des appareils, l'état des services applicatifs et l'état de la transmission des données afin de garantir une identification rapide des problèmes en cas d'anomalies.
Pour les applications nécessitant une maintenance à distance, il convient également de vérifier que les méthodes d'accès à distance, de mise à jour logicielle et de gestion des appareils sont correctement configurées, afin d'éviter toute intervention sur site lors des opérations de maintenance ultérieures.
4.4 Documentation relative à la livraison et maintenance après déploiement
Les appareils industriels en périphérie fonctionnent généralement pendant de nombreuses années. Par conséquent, la livraison ne se limite pas à l'installation de l'appareil ; elle doit également inclure toutes les informations nécessaires à la maintenance en vue d'une assistance ultérieure.
Au cours de la mise en œuvre du projet, il convient de conserver les informations relatives à la configuration des appareils, à la version des logiciels, à la méthode de déploiement des applications et aux consignes de maintenance afin de faciliter les mises à niveau fonctionnelles, les mises à jour de modèles ou le dépannage ultérieurs.
Dans le cadre des projets d'IA en périphérie, le matériel ne constitue qu'une plateforme d'exécution. La maintenance logicielle continue et les itérations des applications ont également une incidence sur le cycle de vie des appareils.
4.5 Problèmes souvent négligés dans les déploiements réels
Dans les projets concrets, une erreur courante consiste à ne valider que la précision des modèles d’IA dans un environnement de laboratoire, tout en négligeant les changements au niveau des ressources qui surviennent après un fonctionnement à long terme des appareils. Par exemple, le système peut fonctionner normalement lors du déploiement initial, mais à mesure que les journaux s’accumulent, que les bases de données grossissent ou que les modèles sont mis à niveau, l’utilisation de la mémoire augmente progressivement et finit par affecter la stabilité de l’application. Ces problèmes n’apparaissent généralement pas lors d’une brève démonstration, mais ils affectent directement les performances à long terme après la livraison du projet. C’est également la raison pour laquelle les projets industriels nécessitent généralement des tests de résistance et une validation sur site, plutôt que de se contenter d’évaluer les capacités de l’appareil uniquement à partir des résultats d’exécution du modèle dans un environnement de développement.
4.6 Critères de non-acceptation
Les conditions suivantes indiquent généralement que la solution doit encore être optimisée :
-
Sous la charge cible, les performances d'inférence de l'IA ne cessent de se dégrader ;
-
La mémoire ne cesse d'augmenter, ce qui indique une fuite de ressources ;
-
Les principaux services d'application se ferment fréquemment ;
-
Les processus métier ne se rétablissent pas automatiquement après la remise en service du réseau ;
-
Des plantages ou des redémarrages anormaux se produisent lors d'un fonctionnement prolongé.
L'objectif de validation d'un ordinateur industriel dédié à l'IA en périphérie consiste à s'assurer que l'appareil peut fonctionner de manière fiable à long terme dans un environnement industriel réel, et non à vérifier ses performances maximales dans des conditions de laboratoire.
5. Résumé des pièges courants
-
Se concentrer uniquement sur les paramètres TOPS et ne pas tenir compte de la charge de travail réelle de l'entreprise.
-
Se contenter de tester les performances de la version de démonstration sans vérifier la capacité de fonctionnement à long terme.
-
Sans tenir compte de l'écosystème logiciel ni de la méthode de déploiement.
-
Choisir du matériel sans prévoir de marge d'extension.
-
Sans tenir compte des interfaces industrielles et de la compatibilité des protocoles.
-
Ne pas tenir compte des futures mises à niveau des modèles et des besoins d'extension des applications.
6. Conclusion
Pour les intégrateurs système et les équipes de projet, un ordinateur industriel dédié à l'IA en périphérie est un nœud de calcul qui doit fonctionner sur le long terme dans le cadre d'un projet. L'architecture détermine la difficulté d'intégration, tandis que la validation sur le terrain détermine la qualité de la mise en service. Une fiche technique n'est qu'un point de départ. Ce qui compte vraiment, c'est la stabilité de fonctionnement en conditions réelles, la facilité de maintenance et la capacité à passer les tests de réception.
De la conception de l'architecture système à la validation sur le terrain, la valeur d'un ordinateur industriel dédié à l'IA en périphérie ne réside pas dans sa puissance de calcul maximale, mais dans sa capacité à fonctionner de manière fiable après la mise en service du projet. Les sites industriels n'ont pas besoin d'une simple démonstration ponctuelle. Ils ont besoin d'une solution d'IA en périphérie capable de fonctionner sur le long terme, d'être entretenue et d'être mise en service en toute confiance.
Agnes Wang est spécialiste des solutions IoT chez IOTRouter ; elle se consacre principalement aux passerelles IoT industrielles, à l'edge computing et aux solutions d'automatisation industrielle.
Elle est spécialisée dans les technologies de communication industrielle, notamment Modbus, la norme CEI 60870-5-104, MQTT, OPC UA, l'intégration d'automates programmables (PLC) et les applications de télésurveillance. Elle contribue à la rédaction d'articles techniques et de guides d'application consacrés aux solutions IoT industrielles, à la conversion de protocoles et à l'edge computing.