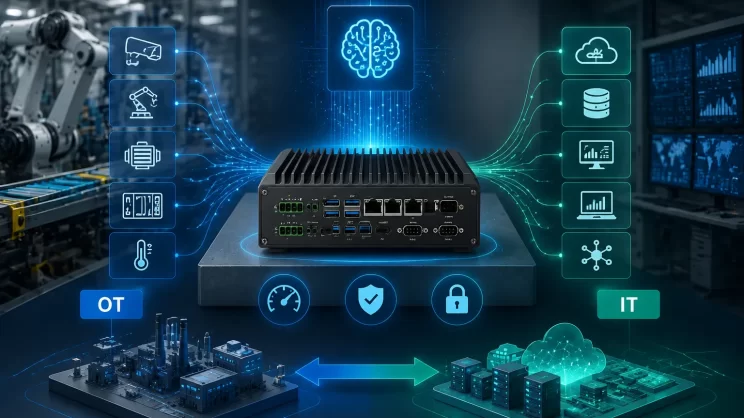
En principio, la tecnología de computación en el borde se utiliza para recopilar, filtrar, procesar y analizar datos “in situ”, en el borde de la red o cerca de él. Se trata de una forma eficaz de utilizar datos que no pueden trasladarse primero a una ubicación centralizada, normalmente porque el enorme volumen de datos hace que dicho traslado resulte costoso, técnicamente inviable o pueda incumplir obligaciones normativas como la soberanía de los datos. Esta definición ha dado lugar a innumerables ejemplos y casos en el mundo real:
Casos de uso de las pasarelas de borde
fabricación
Un fabricante industrial implementó la computación en el borde para supervisar la fabricación, lo que permitió realizar análisis en tiempo real y aplicar el aprendizaje automático en el borde con el fin de identificar errores de producción y mejorar la calidad de fabricación de los productos. La computación en el borde permite instalar sensores ambientales en todas las plantas de fabricación, lo que proporciona información sobre cómo se ensamblan y almacenan los componentes de cada producto, así como sobre el tiempo que permanecen en stock. Ahora, los fabricantes pueden tomar decisiones empresariales más rápidas y precisas sobre las instalaciones de la fábrica y las operaciones de fabricación.
Agricultura. Imaginemos una empresa que cultiva en interiores sin luz solar, tierra ni pesticidas. Este proceso reduce el tiempo de cultivo en más de un 60%. El uso de sensores permite a las empresas realizar un seguimiento del consumo de agua y la densidad de nutrientes, así como determinar el momento óptimo para la cosecha. Recopilar y analizar datos para descubrir el impacto de los factores ambientales, mejorar continuamente los algoritmos de crecimiento de los cultivos y garantizar que estos se cosechen en condiciones óptimas.
Optimización de la red. La computación en el borde puede ayudar a optimizar el rendimiento de la red midiendo el rendimiento de los usuarios en Internet y utilizando posteriormente análisis para determinar la ruta de red más fiable y de menor latencia para el tráfico de cada usuario. En efecto, la computación en el borde se utiliza para “dirigir” el tráfico a través de la red con el fin de lograr un rendimiento óptimo para el tráfico en el que el tiempo es un factor crítico.
Seguridad en el lugar de trabajo. La computación en el borde puede combinar y analizar datos procedentes de cámaras instaladas in situ, equipos de seguridad de los empleados y una gran variedad de sensores para ayudar a las empresas a supervisar las condiciones del lugar de trabajo o garantizar que los empleados cumplan los protocolos de seguridad establecidos, especialmente cuando el lugar de trabajo es remoto o presenta un riesgo inusual, como una obra de construcción o una plataforma petrolífera.
Mejorar la atención sanitaria. El sector sanitario ha incrementado de forma espectacular la cantidad de datos de pacientes recopilados a través de dispositivos, sensores y otros equipos médicos. Estas enormes cantidades de datos requieren el uso de la computación en el borde para aplicar la automatización y el aprendizaje automático con el fin de acceder a los datos, descartar los datos “normales” e identificar los datos problemáticos, de modo que los profesionales sanitarios puedan tomar medidas inmediatas para ayudar a los pacientes a evitar problemas de salud en tiempo real.
Transporte. Los coches autónomos requieren y generan entre 5 y 20 terabytes de datos al día, recopilando información sobre la ubicación, la velocidad, el estado del vehículo, las condiciones de la carretera, las condiciones del tráfico y otros vehículos. Y los datos deben agregarse y analizarse en tiempo real mientras el vehículo está en movimiento. Esto requiere una enorme capacidad de cálculo a bordo, lo que convierte a cada coche autónomo en un “punto periférico”. Además, los datos pueden ayudar a las autoridades y a las empresas a gestionar sus flotas en función de las realidades locales.
Comercio minorista. Las empresas minoristas también pueden generar grandes cantidades de datos procedentes de la supervisión, el seguimiento de inventarios, los datos de ventas y otros detalles empresariales en tiempo real. La computación en el borde puede ayudar a analizar estos datos tan diversos e identificar oportunidades de negocio, como la disposición eficaz de los expositores de cabecera o las campañas, prever las ventas y optimizar los pedidos a los proveedores. Dado que las operaciones minoristas pueden variar enormemente según el entorno local, la computación periférica puede ser una solución eficaz para el procesamiento local en cada tienda.
¿Qué ventajas aportan las pasarelas periféricas?
La computación en el borde resuelve importantes retos de infraestructura —como las limitaciones de ancho de banda, la latencia excesiva y la congestión de la red—, pero además ofrece varias ventajas adicionales que podrían hacer que este enfoque resultara atractivo en otros contextos.
autonomía. La computación en el borde resulta útil en situaciones en las que la conectividad es poco fiable o el ancho de banda es limitado debido a las características ambientales del emplazamiento. Algunos ejemplos son las plataformas petrolíferas, los buques en alta mar, las explotaciones agrícolas remotas u otros lugares apartados, como las selvas tropicales o los desiertos. La computación periférica realiza el procesamiento in situ —a veces en el propio dispositivo periférico—, como es el caso de los sensores de calidad del agua instalados en purificadores de agua de aldeas remotas, y almacena los datos para transmitirlos a un punto central únicamente cuando hay conexión disponible. Al procesar los datos de forma local, se puede reducir significativamente la cantidad de datos que hay que enviar, lo que requiere mucho menos ancho de banda o tiempo de conexión de lo que se necesitaría de otro modo.
Soberanía de los datos. El traslado de grandes cantidades de datos no es solo una cuestión técnica. El tránsito de los datos a través de fronteras nacionales y regionales puede generar problemas adicionales relacionados con la seguridad de los datos, la privacidad y otras cuestiones legales. La computación en el borde (edge computing) puede utilizarse para acercar los datos a su origen y mantenerlos dentro de los límites de las leyes vigentes en materia de soberanía de datos, como el RGPD de la UE, que define cómo se almacenan, tratan y divulgan los datos. Esto permite que los datos sin procesar se traten localmente, ocultando o protegiendo cualquier dato sensible antes de enviar nada a la nube o a grandes centros de datos que puedan estar ubicados en otras jurisdicciones.