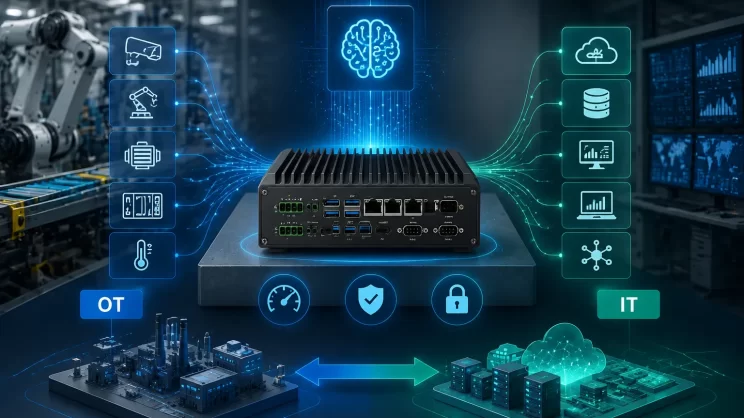
Em princípio, a tecnologia de computação na periferia é utilizada para recolher, filtrar, processar e analisar dados “in situ”, na periferia da rede ou nas suas proximidades. Esta é uma forma eficaz de utilizar dados que não podem ser transferidos primeiro para uma localização centralizada — normalmente porque o próprio volume de dados torna essa transferência dispendiosa, tecnicamente impraticável ou pode violar obrigações de conformidade, tais como a soberania dos dados. Esta definição gerou inúmeros exemplos e casos na prática:
Cenários de aplicação do gateway de borda
fabrico
Um fabricante industrial implementou a computação na periferia para monitorizar o processo de fabrico, permitindo análises em tempo real e aprendizagem automática na periferia, com o objetivo de identificar erros de produção e melhorar a qualidade do fabrico dos produtos. A computação na periferia permite a instalação de sensores ambientais em todas as fábricas, fornecendo informações sobre a forma como cada componente do produto é montado e armazenado — e durante quanto tempo esses componentes permanecem em stock. Os fabricantes podem agora tomar decisões empresariais mais rápidas e precisas sobre as instalações fabris e as operações de produção.
agricultura. Considere uma empresa que cultiva plantas em ambientes fechados, sem luz solar, solo nem pesticidas. Este processo reduz o tempo de cultivo em mais de 60%. A utilização de sensores permite às empresas monitorizar o consumo de água e a densidade de nutrientes, bem como determinar o momento ideal para a colheita. Recolher e analisar dados para identificar o impacto dos fatores ambientais, melhorar continuamente os algoritmos de crescimento das culturas e garantir que estas sejam colhidas nas melhores condições possíveis.
Otimização da rede. A computação na periferia pode ajudar a otimizar o desempenho da rede, medindo o desempenho dos utilizadores na Internet e, em seguida, recorrendo a análises para determinar o caminho de rede mais fiável e de baixa latência para o tráfego de cada utilizador. Na prática, a computação na periferia é utilizada para “direcionar” o tráfego pela rede, de modo a garantir um desempenho ideal para o tráfego sensível ao tempo.
Segurança no local de trabalho. A computação de ponta pode combinar e analisar dados provenientes de câmaras instaladas no local, de equipamento de segurança dos colaboradores e de uma variedade de outros sensores, para ajudar as empresas a monitorizar as condições no local de trabalho ou a garantir que os colaboradores cumprem os protocolos de segurança estabelecidos — especialmente quando o local de trabalho é remoto ou invulgarmente perigoso, como um estaleiro de construção ou uma plataforma petrolífera.
Melhorar os cuidados de saúde. O setor da saúde aumentou drasticamente a quantidade de dados de doentes recolhidos a partir de dispositivos, sensores e outros equipamentos médicos. Estas enormes quantidades de dados exigem a computação de ponta para aplicar automação e aprendizagem automática, de modo a aceder aos dados, ignorar os dados “normais” e identificar os dados problemáticos, para que os profissionais de saúde possam tomar medidas imediatas para ajudar os doentes a evitar problemas de saúde em tempo real.
transportes. Os carros autónomos requerem e produzem entre 5 e 20 terabytes de dados por dia, recolhendo informações sobre a localização, a velocidade, o estado do veículo, as condições da estrada, as condições de tráfego e outros veículos. E os dados têm de ser agregados e analisados em tempo real enquanto o veículo está em movimento. Isto requer uma capacidade computacional a bordo enorme — tornando cada carro autónomo um “ponto de borda”. Além disso, os dados podem ajudar as autoridades e as empresas a gerir as suas frotas com base nas realidades locais.
retalho. As empresas de retalho também podem gerar grandes quantidades de dados provenientes da monitorização, do acompanhamento de inventário, dos dados de vendas e de outros detalhes operacionais em tempo real. A computação de perifeira pode ajudar a analisar estes dados diversificados e a identificar oportunidades de negócio, tais como disposições eficazes nas extremidades das prateleiras ou campanhas, prever vendas e otimizar as encomendas aos fornecedores. Uma vez que as operações de retalho podem variar significativamente consoante os contextos locais, a computação de perifeira pode ser uma solução eficaz para o processamento local em cada loja.
Que vantagens oferecem os gateways de perímetro?
A computação na periferia resolve importantes desafios de infraestrutura — tais como limitações de largura de banda, latência excessiva e congestionamento da rede —, mas apresenta vários benefícios adicionais potenciais que podem tornar esta abordagem atraente noutros contextos.
autonomia. A computação de ponta é útil em situações em que a conectividade não é fiável ou a largura de banda é limitada devido às características ambientais do local. Entre os exemplos contam-se plataformas petrolíferas, embarcações offshore, explorações agrícolas remotas ou outros locais remotos, como florestas tropicais ou desertos. A computação de ponta realiza o processamento no local — por vezes no próprio dispositivo de ponta —, como é o caso dos sensores de qualidade da água em purificadores de água em aldeias remotas, e guarda os dados para transmissão para um ponto central apenas quando existe ligação disponível. Ao processar os dados localmente, a quantidade de dados a enviar pode ser significativamente reduzida, exigindo muito menos largura de banda ou tempo de ligação do que seria necessário de outra forma.
Soberania dos dados. A transferência de grandes quantidades de dados não é apenas uma questão técnica. A circulação de dados através das fronteiras nacionais e regionais pode criar problemas adicionais relacionados com a segurança dos dados, a privacidade e outras questões legais. A computação de ponta pode ser utilizada para aproximar os dados da sua fonte e mantê-los dentro dos limites das leis de soberania de dados existentes, tais como o RGPD da UE, que define a forma como os dados são armazenados, processados e divulgados. Isto permite que os dados brutos sejam processados localmente, ocultando ou protegendo quaisquer dados sensíveis antes de enviar qualquer informação para a nuvem ou para grandes centros de dados que possam estar localizados noutras jurisdições.